是台刚换了主轴的卧式加工中心,前一天白班切钛合金叶轮的时候,突然崩了刀——没提前任何预警,毛坯直接被划了一道两毫米深的口子,算下来小三十万的料,半废。
旁边的班组老师傅蹲在地上抽烟,烟圈飘到头顶的行车轨道上,骂骂咧咧说早知道上周就该把主轴拆下来查轴承,他前几天摸主轴外壳的时候就觉得温度不对,比平时烫了快十度。
我没接话。这就是我们现在费劲做状态监测的原因。
别把状态监测等同于“装个传感器”
刚入行做这行的时候,我对状态监测的认知和大多数人一样——不就是在设备上贴几个传感器,把数据传到后台,超了阈值就报警?
真上手才知道有多蠢。
最早我们在车间试装,给每台机床的主轴轴承座上贴了振动传感器,跑了一周,采回来的振动值跳得跟过山车似的。一开始以为是轴承快坏了,拆下来查了个底朝天,半毛钱问题没有。后来蹲了三天才搞明白,车间里的行车每次吊个几吨的钢坯从旁边过,地面震一下,传感器就跳一次数。

那之后我才明白,状态监测从来不是“装上设备就完事”的一锤子买卖。你得先搞清楚,哪些信号是设备本身的状态变化,哪些是周围环境的干扰。
同样是振动值涨了0.2个g。
如果设备是空载怠速转,那大概率是轴承滚道进了铁屑,或者润滑脂干了;如果设备正在切大余量的淬硬钢,那说不定就是正常的切削负载波动,根本算不上异常。
我之前踩过最大的坑,就是图省事给所有设备设了统一的固定阈值报警,结果一到换班换刀,机床刀库撞一下定位块,系统就狂响。闹了半个月,车间师傅嫌烦,直接把报警线拔了。
白搭。
那些藏在数据里的“小动作”,才是真的预警
现在我们盯的参数,说出来一点都不高大上。
主轴的表面温度,振动的频谱特征,主轴电机的运行电流,循环润滑油里的金属颗粒浓度。
就这几样。
最开始我也觉得,这些参数有什么好盯的?直到去年那台磨床的事。
那台磨床给风电齿轮做精磨,之前我们一直盯着它的电流曲线,那天看后台数据的时候发现,连续一周,相同的磨削参数下,它的电流比同型号的另外两台磨床高了0.3A。
数值小到什么程度?你拿个钳形表卡上去,不仔细看根本注意不到。
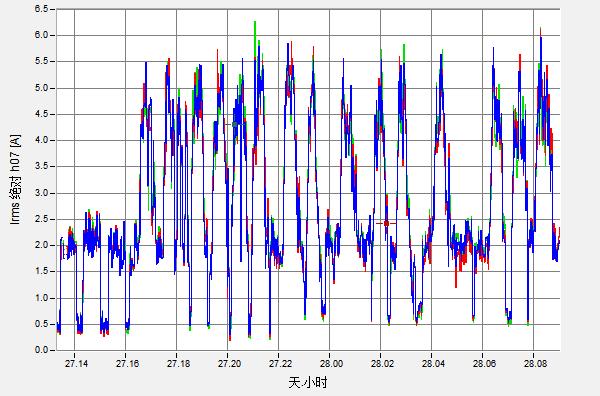
我们没敢大意,停机拆了砂轮,转起来一看,动平衡块掉了小半块。再跑个两三天,砂轮偏心带来的振动会直接传到主轴轴承上,到时候烧了轴承,换一次得二十多万,还要等一周的备件。
那天把平衡块补好,重新做了动平衡,电流一下就回到了正常区间。
说真的,这就是状态监测最爽的地方——你比设备自己还先知道它要出问题。不用等师傅靠手摸、靠耳朵听去猜,不用等故障闹大了才停机救火,那些藏在数据里的微小波动,提前个三五天就能把隐患揪出来。
别信那些吹得神乎其神的“全智能预测”。很多时候就是把老工程师攒了十几年的经验,拆成了可量化的数值而已。老师傅摸一下外壳就知道温度高不高,听一下声音就知道轴承有没有问题,我们做的事,就是把这些没法量化的经验,变成不会累、不会忘、不会因为换班就断档的监测逻辑。
做了五年现场监测,踩过最多的误区
跑了快二十个车间,我发现大家对状态监测的误解,真的比设备本身的故障还多。
第一个误区,是不是传感器装得越多越好?
真不是。上个月去邻市的一个汽配厂交流,他们新上的监测系统,给每台冲压机装了12个传感器,光数据采集终端就花了大几百万。结果后台存了三个多月的数,连个正经的趋势分析都没跑过,所有的报警都是固定阈值,超了就发个短信给设备管理员,管理员嫌烦直接把短信通知关了。
纯纯的面子工程。
传感器装得再多,没人盯着数据做分析,跟在设备上贴了个金属片有什么区别?
第二个误区,是不是所有设备都要上状态监测?
也不对。比如车间里的普通台钻,用了二十年,坏了换一台也就两千块,你花两万装套监测系统,图啥?
对吧?
真正值得上状态监测的设备,永远是那些坏了会停整条生产线、维修成本高、备件难等的家伙。比如刚才说的加工钛合金的卧加,比如做风电齿轮的滚齿机,比如给航空件做加工的五轴设备。这些家伙,停一小时的损失,够付一整年的监测服务费。
还有个最容易被忽略的难点,就是车间里无处不在的信号干扰。电磁干扰、地面震动、温度骤变,全是会影响数据准确性的因素。之前我们采润滑油的金属颗粒数据,连着一周数值飘得厉害,以为是轴承在剧烈磨损,把油管拆了查了半天,才发现是旁边的切削液管路漏了,铁屑顺着缝隙混进润滑油里了。
闹了个大乌龙。
现在很多人聊工业互联网,聊数字孪生,好像状态监测是什么飘在云上的黑科技。
其实说白了,就是把以前老师傅那些靠经验攒的、容易因为人员流动就丢了的本事,换成了不会偷懒的传感器和不会乱删的数据库。
它没有那么神。
就是能少几次半夜爬起来去车间救火,少几个因为设备崩刀废了的昂贵毛坯,少点维修的时候拆半天找不到问题的糟心。
毕竟在车间待过的人都知道,最好的维修,永远是让设备根本别坏。